本页目录
模型与定价
AIonRouter 采用完全透明、按量付费的扣费机制。所有可用模型的价格、计费类型、折扣以及兼容端点,均在模型广场实时公开。
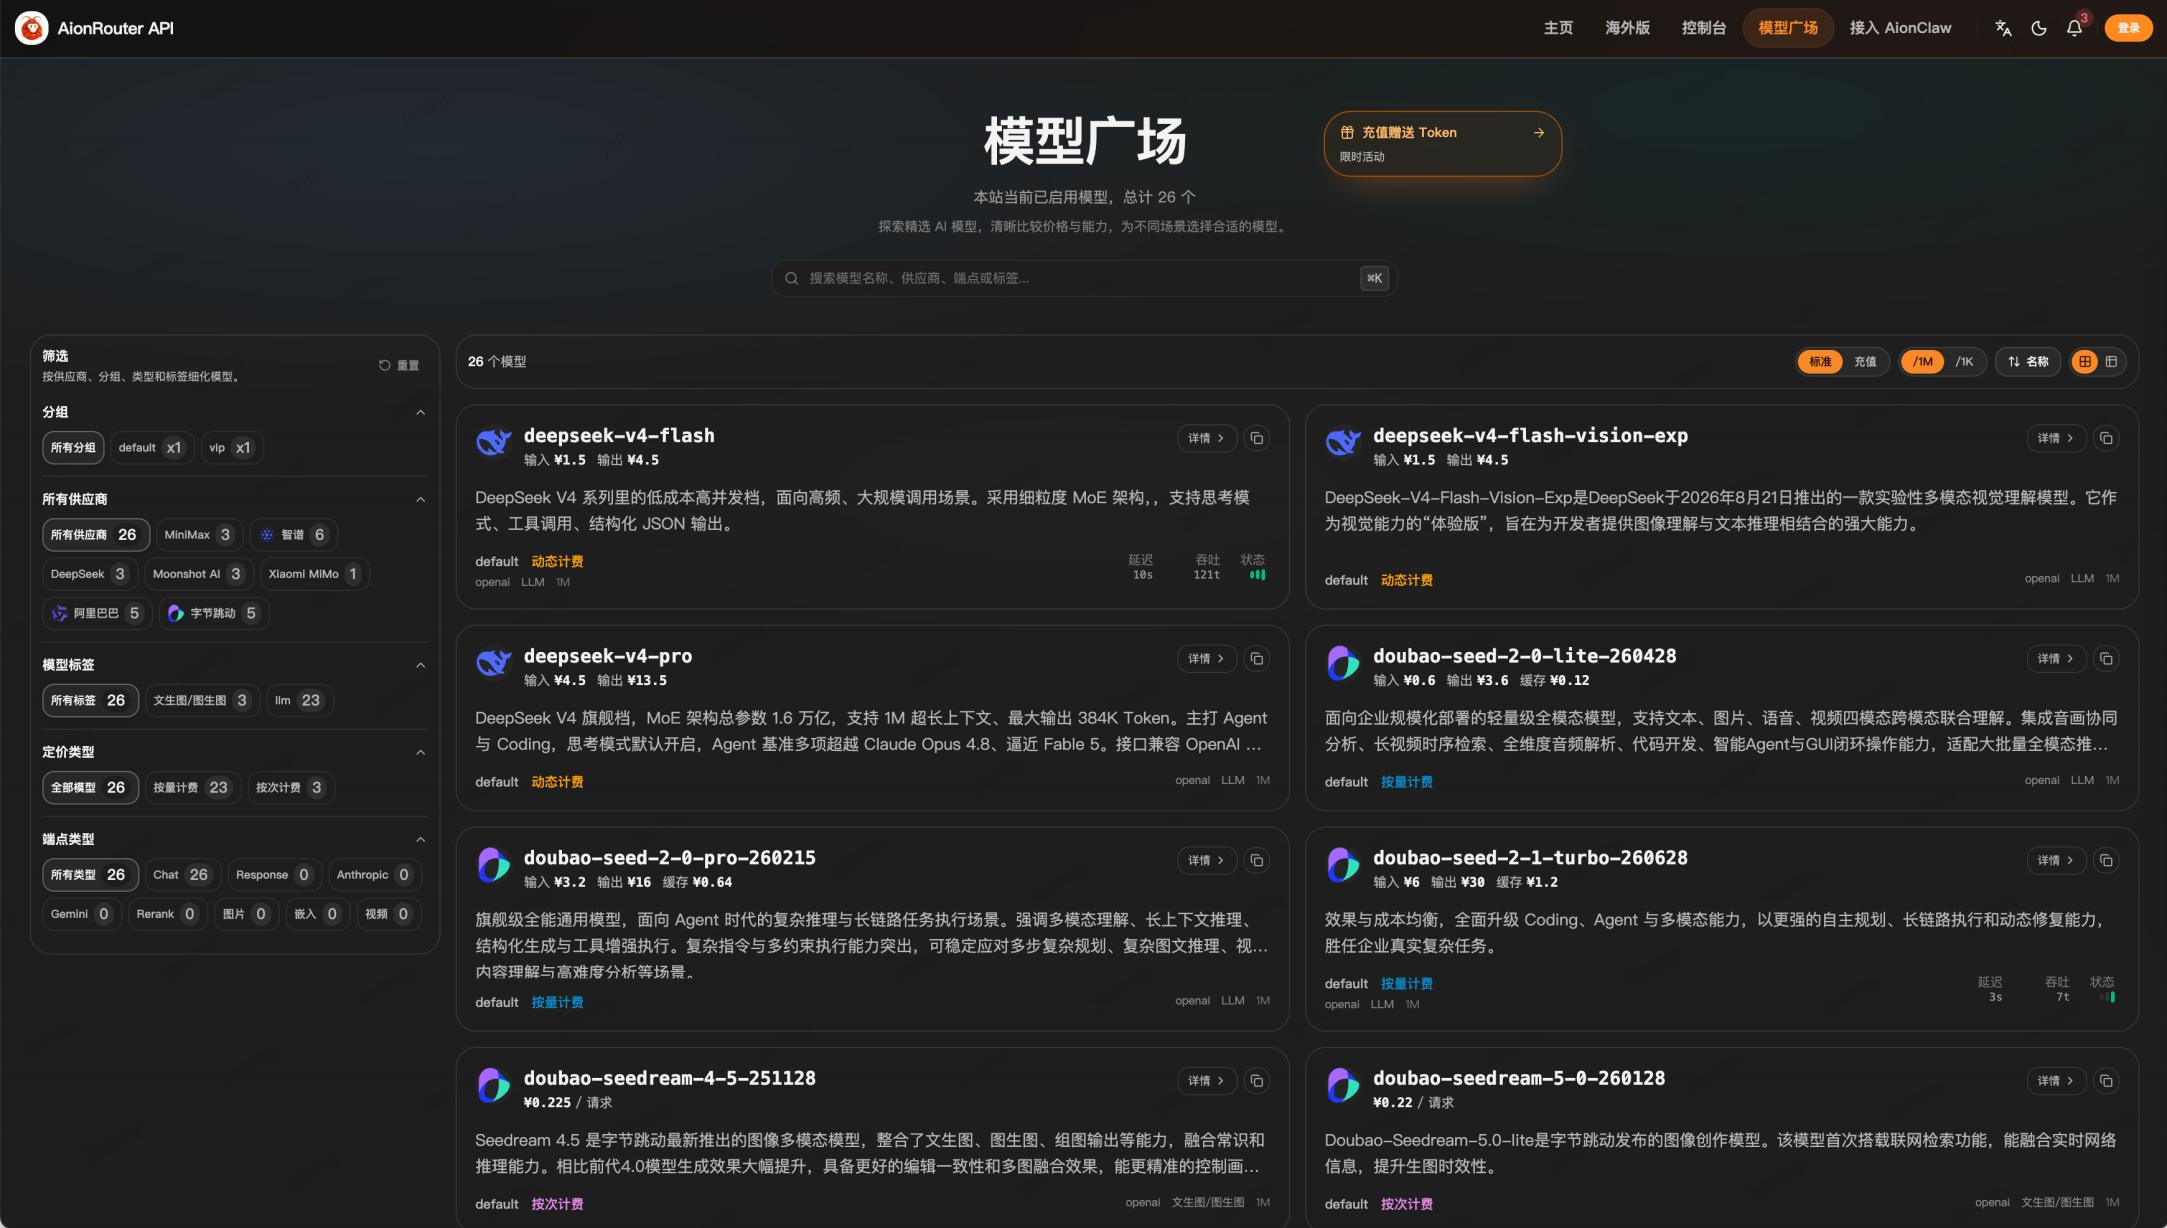
如何阅读模型价格
在模型广场中,您可以非常直观地看懂每—个模型的收费细节:
1. 计费类型
- 按量计费: 最常见:根据您的输入(Prompt)和输出(Completion)所消耗的 Token 数量进行收费。价格通常按每百万 Token(/ 1M Tokens)展示,您可以点击右上角的「切换为 1K 价格」切换为每千 Token 的价格。
- 按次计费: 部分多模态、工具类或特殊模型(例如 doubao-seedream-4-5-251128)采用固定单次请求计费,无论输入输出多少内容,单次调用扣除固定积分。
2. 上下文缓存
为了帮助用户最大化降低长文本(如长代码库、长文档对话)的调用成本,AIonRouter 针对支持缓存的模型(如 Deepseek 系列、Gemini 系列)提供了极其细致的缓存计费:
| 项目 | 说明 |
|---|---|
| 输入 | 正常发送未命中的提示词价格。 |
| 缓存读取 | 命中缓存时的超低价格。通常仅为正常输入单价的 10% 左右。 |
| 缓存写入 | 首次将大文本写入缓存时的价格。 |
按量计费公式
当您调用—个按量计费的模型时,单次调用的实际积分扣除公式如下:
实际消耗 = Token 数量 ÷ 100万 × 对应单价
提示:实际扣费会在 API 调用成功后,根据上游返回的真实 Token 使用量在您的账户余额中秒级完成扣减。
提示:实际扣费会在 API 调用成功后,根据上游返回的真实 Token 使用量在您的账户余额中秒级完成扣减。
成本优化建议
- 按需选择模型
- 使用上下文缓存: 在开发工具(如 Claude Code 或 Cline)中,尽量保持 Prompt 前半部分(如系统指令、核心代码定义)结构稳定,这样可以频繁命中缓存,最高可省下 90% 的输入成本。
- 设置密钥限额: 在创建 API Key 时,为开发、测试等不同的 Key 分配独立的最大额度,防止代码因死循环或异常调用导致意外透支。